Галлюцинации ИИ: почему нейросети ошибаются и как их проверять
Убедительный ответ не гарантирует правильный. Разбираемся, откуда берутся выдумки в текстах нейросетей и что проверять в первую очередь.
Галлюцинации ИИ — это сгенерированный текст, который выглядит связным и уверенным, но содержит фактически неверные или выдуманные сведения. В профессиональной литературе для этого явления также используют термин «конфабуляция».
Вы просите нейросеть подобрать источники для статьи, и через десять секунд получаете список из пяти книг с точными названиями, годами издания и цитатами. Открываете первую — книга существует, вторую — тоже, но автор другой. Третьей в каталоге библиотеки нет вовсе. Формулировки при этом были безупречны.
Такая ситуация — не сбой конкретной модели, не признак того, что система «решила соврать». Это такая особенность работы языковых моделей, о которой полезно знать до того, как вы вставите сгенерированный абзац в рабочий документ.
Что такое галлюцинации ИИ
Представьте, что вы просите модель описать биографию малоизвестного исследователя. Если в обучающих данных о нём почти нет информации, система всё равно выдаст текст: имя, годы жизни, область работы, ключевую публикацию. Факты могут оказаться смесью сведений о разных людях или полностью вымышленными. Форма останется правильной: абзацы, заголовки, академический стиль.
Галлюцинация отличается от художественного вымысла по заданию. Если вы просите рассказ от лица вымышленного персонажа, вымысел — часть задачи. Если вы просите факты, но получаете вымысел в форме фактов, это ошибка генерации. Отличается она и от оценки, с которой вы не согласны: спорное мнение о фильме или книге галлюцинацией не становится.
Галлюцинация там, где утверждение подаётся как фактическое и оказывается ложным.
Есть ещё одна граница, которую полезно держать в голове. Модель может дать устаревшую информацию: факт был верен на момент обучения, но с тех пор изменился. Формально это не выдумка, а несвежесть данных. Проверять такие утверждения нужно так же, как и выдуманные, — по актуальному первоисточнику.
Почему нейросеть может уверенно ошибаться
Языковая модель учится на огромных массивах текста предсказывать следующее слово. Вероятное продолжение фразы «столица Франции —» — «Париж», потому что такое сочетание встречалось в данных миллионы раз.
Вероятность правильного продолжения не равна знанию факта. Если в данных мало информации о редком событии или человеке, модель строит наиболее вероятную с точки зрения языка конструкцию. Иногда она совпадает с реальностью, иногда нет.
Доступ к поиску и инструментам проверки зависит от продукта и настроек. Он снижает частоту некоторых ошибок, но не устраняет их полностью. Поиск может найти страницу, которая не содержит нужного утверждения. Инструмент может вернуть данные, которые модель интерпретирует неточно.
Фраза «эта модель с интернетом, значит, не галлюцинирует» неверна как общее правило.
Слово «галлюцинация» удобно для обсуждения, но создаёт ложное впечатление, будто система что-то воспринимает и искажает. Точнее говорить о генерации правдоподобного текста при отсутствии достаточных оснований для точности. Такое описание помогает не приписывать модели человеческие свойства и оценивать результат по проверяемости, а не по уверенности тона.
Какие ошибки встречаются в ответах
Ниже — типичные формы, с которыми сталкиваются пользователи текстовых моделей. Примеры вымышлены и приведены для иллюстрации, они не описывают поведение какой-либо конкретной модели.
Выдуманная ссылка. Модель приводит статью с названием, похожим на реальное, и указывает журнал, в котором такая статья могла бы выйти. При переходе по ссылке страница не открывается или содержит другой материал.
Неверная дата или число. В обзоре исследования модель указывает год публикации, который не совпадает с фактическим или приводит процент, который звучит правдоподобно, но не встречается в исходной работе.
Смешение людей. В биографической справке соединяются факты о двух специалистах с одинаковой фамилией: образование одного, должность другого, публикации третьего.
Неподтверждённый вывод. Модель обобщает единичный случай до закономерности: «исследования показывают, что…», хотя речь шла об одной небольшой работе без воспроизведения.
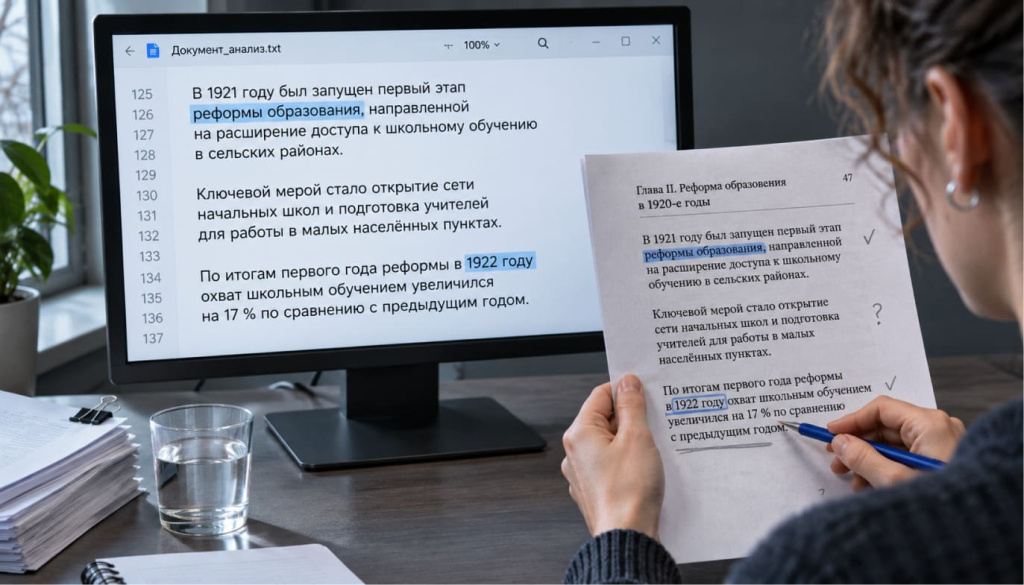
Подмена контекста. Цитата приводится верно, но опускается условие, при котором она была сказана. Читатель делает вывод, противоположный смыслу источника. Это встречается чаще, чем полная выдумка, и распознаётся только при сверке с полным текстом.
Почему мы верим убедительной формулировке
Связный текст с правильными абзацами и переходами воспринимается как признак компетентности. Психологически это понятно: мы привыкли, что если человек говорит гладко и подробно, он разбирается в теме. С нейросетью эта привычка даёт сбой.
Подробность усиливает эффект. Когда модель называет точные даты, имена и названия журналов, создаётся ощущение проверенной информации. Чем больше деталей, тем выше готовность доверять — даже если ни одна из них не соответствует действительности.
Совпадение с ожиданиями тоже играет роль. Если ответ подтверждает то, что вы и так предполагали, проверять его хочется меньше. Здесь работает обычная экономия усилий: мозг не тратит ресурс на проверку того, что не вызывает внутреннего сопротивления. Полезно замечать этот момент и задавать себе вопрос: я не проверяю потому, что уже проверил, или потому, что ответ удобен?
Как проверить факты и источники
Проверка не требует специального образования — достаточно последовательности действий, которую можно применять к любому ответу, если вы собираетесь использовать его в работе или личных решениях.
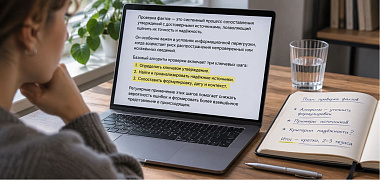
Шаг 1. Выделите проверяемые утверждения. Не нужно проверять весь текст. Отметьте то, что можно подтвердить или опровергнуть: имена, даты, числа, названия организаций, ссылки на исследования, цитаты.
Шаг 2. Откройте первоисточник. Если модель ссылается на статью, найдите её в базе публикаций или на сайте журнала. Если на книгу — проверьте наличие в каталоге библиотеки или издательства. Ссылка в ответе модели не заменяет первоисточник.
Шаг 3. Проверьте автора и дату. Даже реальная статья может быть старой, а её выводы — пересмотренными позже. Автор может быть специалистом в другой области.
Шаг 4. Сверьте контекст. Утверждение, вырванное из абзаца, может означать не то, что означает в полном тексте. Модель иногда корректно цитирует фразу, но опускает условие, при котором она была сказана.
Шаг 5. Задайте вопрос другой модели. Это дополнительный сигнал, а не независимое доказательство. Если две модели обучены на похожих данных, они могут воспроизвести одну и ту же ошибку. Совпадение ответов не подтверждает факт.
Эти шаги не гарантируют, что вы найдёте все ошибки. Они снижают риск использовать в работе утверждение, которое не выдерживает проверки. Подробнее о том, как устроен такой подход, — в материале о критическом мышлении.
Учебный пример проверки ответа
Вы просите модель подобрать источники по теме влияния короткого сна на внимание. В ответе — книга с названием, похожим на реальное издание, и цитата из главы третьей. Модель утверждает, что автор книги — известный исследователь сна, и приводит выходные данные.
Что делать
1. Открываете каталог Российской государственной библиотеки или сайт издательства. В поисковую строку вводите название книги в кавычках — каталог не находит издание либо показывает похожие книги с другими авторами.
2. Проверяете автора по фамилии: специалист с такой фамилией существует, но книга за его авторством в открытых каталогах не значится.
3. Ищете фразу из цитаты в поисковике — она не встречается ни в одной публикации.
Вывод: источник вымышлен, использовать его нельзя. Если тема важна, ищете реальные обзоры по запросу с ключевыми словами на русском и английском, отбираете те, у которых указан автор, журнал и год.
Это не означает, что модели всегда выдумывают. Но означает, что их нужно всегда проверять.
Где нужна особенно тщательная проверка
Есть области, в которых цена ошибки очень высока, и фактчекинг необходим максимально тщательный.
- Медицинские решения: дозировки, взаимодействия препаратов, интерпретация симптомов.
- Юридические вопросы: применимость нормы, сроки, процессуальные детали.
- Финансовые решения: условия договора, налоги, расчёты.
В этих темах ответ нейросети может быть отправной точкой для поиска, но не основанием для действия. Проверка у специалиста или в официальном источнике обязательна.
Отдельно — персональные данные и рабочие документы. Не стоит вставлять в запрос конфиденциальные сведения, если вы не уверены, как сервис обрабатывает и хранит данные. Даже при наличии настроек приватности правило «не отправляй то, что не готов увидеть в чужом логе» остаётся разумным.
Как использовать ИИ с пользой
Не нужно отказываться от нейронок, в наше время их используют все и будут использовать дальше. Но важно распределение ролей: модель генерирует варианты, пользователь принимает решение о том, что из них соответствует действительности.
Нейросети экономят наше время. Они могут: набросать структуру текста, предложить формулировки для письма, собрать список вопросов по теме, переписать абзац в другом тоне, дать черновик плана. Во всех этих случаях вы оцениваете результат по критериям, которые можете проверить сами: логика, полнота, уместность тона.
Существенные факты и выводы остаются за вами. Если вы используете сгенерированный текст в рабочем документе, проверка фактов — часть работы, а не дополнительная опция. Навык, который здесь нужен, — не технический. Это привычка задавать вопрос «откуда это известно» и находить ответ до того, как информация уйдёт дальше.
Развивать такую привычку можно системно. На программе «Новый интеллектуальный ресурс. Критическое мышление с ИИ» разбирают принципы анализа информации и рассуждений. Посмотрите содержание и формат обучения, если хотите перейти от отдельных приёмов проверки к более устойчивой практике.
Развивайте навык критического мышления
На программе «Критическое мышление с ИИ» можно познакомиться с принципами анализа информации и рассуждений. Посмотрите содержание и формат обучения.
Посмотреть программуFAQ (Часто задаваемые вопросы)
?Галлюцинации ИИ — это ложь?
Нет. Ложь предполагает намерение ввести в заблуждение, а у языковой модели нет намерения. Она генерирует вероятное продолжение текста. Результат может быть фактически неверным, но это ошибка генерации, а не сознательный обман.
?Ошибается ли модель с доступом в интернет?
Да, может. Поиск снижает частоту некоторых ошибок, но не устраняет их. Модель может неверно интерпретировать найденную страницу, выбрать источник с сомнительной надёжностью или соединить факты неправильно. Проверка первоисточника остаётся необходимой.
?Можно ли доверять ответу со ссылками?
Ссылки в ответе — приглашение к проверке, а не подтверждение. Они могут вести на реальные страницы, которые не содержат указанного утверждения. Могут быть устаревшими или относиться к другому контексту. Открывайте ссылку и сверяйте текст.
?Помогает ли повторный вопрос?
Иногда. Если переформулировать запрос и получить тот же ответ, это может быть слабым сигналом устойчивости информации. Но две модели на похожих данных могут воспроизвести одну ошибку. Повторный вопрос не заменяет проверку по первоисточнику.
?Можно ли полностью исключить галлюцинации промптом?
Нет. Промпт влияет на качество ответа, но не гарантирует фактическую точность. Даже детальный запрос с указанием источников не устраняет риск ошибки. Ответственность за проверку существенных утверждений остаётся у пользователя.
Главное
Галлюцинации ИИ — следствие того, как языковая модель строит текст: по вероятности продолжения, а не по сверке с фактами. Уверенный тон и подробности не доказывают точность. Проверяйте имена, даты, числа, ссылки и цитаты по первоисточникам. Если ответ используется в рабочем документе или влияет на решение с последствиями, проверка обязательна. Нейросеть удобна для черновиков и вариантов, но окончательное суждение о фактах остаётся за человеком.
Об авторе
Мария Павловна Коннова — врач-психотерапевт, со-руководитель АПиМ, методолог программы профессиональной переподготовки. Практикующий специалист, супервизор, ведёт клиентский приём, преподаёт системную психотерапию.
Статьи по теме